Un modèle français appelé via un opérateur soumis à un droit étranger reste exposé à ce droit. Un modèle ouvert exécuté sur votre infrastructure réduit fortement votre dépendance et votre exposition, sans tout régler pour autant.
La souveraineté d'un agent IA ne se lit pas sur le drapeau de son modèle. Elle se joue dans son architecture : où il tourne, quel droit s'applique à celui qui l'opère, qui accède à ce qu'il voit, et si vous pouvez en changer demain.
En France, le débat se résume souvent à une question : « modèle français ou modèle américain ? ». C'est une bonne question, mais elle n'est pas suffisante. Pour une PME qui confie à un agent ses e-mails, ses devis ou son CRM, ce qui compte, c'est de savoir qui peut, en droit et en pratique, accéder à ce que l'agent voit. Et de savoir si elle peut en reprendre le contrôle.
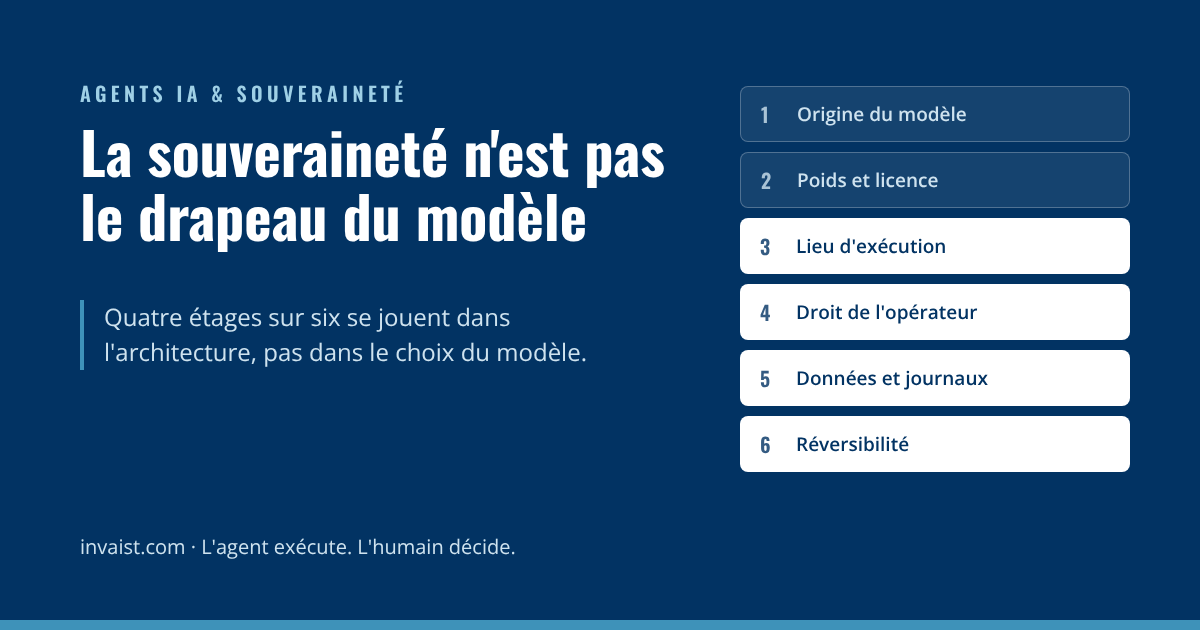
Les six étages de la souveraineté
Un agent peut être maîtrisé à un étage et dépendant à un autre. La nationalité du modèle n'est que le premier.
| Étage | La question à poser | Ce qui renforce la maîtrise |
|---|---|---|
| 1. L'origine du modèle | Qui l'a entraîné, sur quelles données, avec quels choix ? | Un éditeur identifié, une documentation publiée |
| 2. Les poids et la licence | Peut-on télécharger le modèle ? Que permet la licence ? | Des poids disponibles et une licence qui autorise votre usage, l'hébergement et la modification |
| 3. Le lieu d'exécution | Où tourne-t-il quand l'agent travaille ? | Vos serveurs, ou un hébergeur que vous choisissez |
| 4. Le droit de l'opérateur | Quelle entité opère le service, qui la contrôle, qui sont ses sous-traitants, qui détient les clés de chiffrement ? | Une exposition aux lois étrangères analysée et acceptée en connaissance de cause |
| 5. Les données, journaux et mémoire | Où vont-ils, qui peut les lire, combien de temps sont-ils gardés ? | Des accès limités, du chiffrement, une durée de conservation et une suppression définies |
| 6. La réversibilité | Peut-on changer de modèle ou de fournisseur sans tout reconstruire ? | Des règles hors du modèle, des formats et des API standards, des données exportables, des compétences en interne ou chez un partenaire |
Aucun étage ne suffit seul. Un hébergement interne réduit la dépendance, mais laisse celles au matériel, aux mises à jour, aux composants tiers et aux équipes. Il ne garantit pas non plus, à lui seul, la sécurité ni la conformité.
La disponibilité des poids dit si l'on peut télécharger le modèle. La licence dit ce qu'on a le droit d'en faire. L'ouverture au sens de l'Open Source Initiative va plus loin : sa définition 1.0 de l'IA open source, publiée en octobre 2024, demande aussi une description complète des données d'entraînement et la publication du code utilisé. Un modèle peut donc avoir des poids téléchargeables sous licence permissive sans être « open source » au sens de l'OSI. Pour une PME, la question pratique reste : la licence couvre-t-elle mon usage, l'hébergement et la modification ?
Cinq familles de modèles, aucune parfaite
Chaque famille a ses forces et ses angles morts. Le bon choix dépend de vos données, pas d'une préférence de principe.
| Famille | Exemples | Forces | Points de vigilance |
|---|---|---|---|
| Modèles français | Mistral AI, LightOn | Proximité juridique et linguistique ; selon Mistral, la plupart de ses modèles ouverts sont sous Apache 2.0 | Certains modèles Mistral ont une licence MIT modifiée (licence commerciale au-delà de 20 M$ de chiffre d'affaires mensuel) : vérifier modèle par modèle. Et par quelle plateforme le consommez-vous ? |
| Modèles européens | OpenEuroLLM (20 organisations, lancé en février 2025) | Logique ouverte, langues européennes | Projet de recherche en cours, pas encore une offre éprouvée ; être européen ne rend pas un modèle automatiquement conforme à l'AI Act |
| Poids ouverts, éditeurs américains | gpt-oss d'OpenAI (Apache 2.0, août 2025), Llama de Meta | Exécutables sur votre infrastructure, hors du service en ligne de l'éditeur | Poids ouverts ne veut pas dire entraînement reproductible ; la licence Llama comporte des restrictions d'usage et Llama ne répond pas à la définition 1.0 de l'OSI, selon l'analyse publiée |
| Poids ouverts, éditeurs chinois | DeepSeek-R1 (MIT), Qwen3 (Apache 2.0) | Licences permissives, large diffusion | Provenance et biais d'entraînement à évaluer ; les variantes « distillées » de DeepSeek-R1 héritent de la licence de leur modèle de base (Qwen ou Llama) |
| Services américains en ligne | Les grands assistants et API d'OpenAI, Google, Anthropic… | Faciles à brancher, engagements contractuels pour les offres entreprise | L'opérateur relève du droit américain, même quand le traitement a lieu en Europe : exposition à analyser selon vos données |
Le cas DeepSeek montre pourquoi il faut distinguer le service en ligne et le modèle. Le 30 janvier 2025, l'autorité italienne de protection des données a ordonné en urgence la limitation du traitement des données des utilisateurs italiens par le chatbot DeepSeek et ouvert une enquête. Elle a jugé insuffisante la réponse des deux sociétés chinoises, qui affirmaient ne pas opérer en Italie et ne pas être soumises au droit européen.
Cette décision visait le service en ligne, pas le modèle téléchargeable. Exécuté sur vos serveurs, ce modèle ne dépend plus de ce service. Encore faut-il vérifier que l'application qui l'entoure, ses extensions et ses outils n'envoient pas eux-mêmes des données à l'extérieur.
Un serveur en France ne suffit pas
Le 10 juin 2025, devant une commission d'enquête du Sénat, les représentants de Microsoft France ont été interrogés sous serment. Le compte rendu rapporte trois choses, qu'il faut lire ensemble.
Selon Microsoft, depuis janvier 2025 et en vertu d'une garantie contractuelle, les données de ses clients européens, journaux compris, ne sortent pas de l'UE.
Microsoft dit analyser la validité de chaque demande des autorités américaines et rejeter celles qui sont infondées. Mais « lorsque nous sommes obligés de les donner, nous les donnons ».
Garantir que des données de citoyens français ne seraient jamais transmises sans accord des autorités françaises ? « Non, je ne peux pas le garantir, mais, encore une fois, cela ne s'est encore jamais produit. »
Cette réponse ne traduit pas une mauvaise volonté : elle décrit une réalité juridique. Le CLOUD Act, loi américaine de 2018, permet aux autorités des États-Unis d'exiger, dans le cadre d'une procédure légale, qu'un fournisseur soumis à leur juridiction produise des données en sa possession ou sous son contrôle, y compris stockées hors des États-Unis. Cela ne signifie pas que vos données sont transmises automatiquement. Cela signifie qu'une exposition existe, et qu'elle dépend du droit qui s'applique à l'opérateur, pas seulement de l'adresse du centre de données.
Trois repères pour situer le débat :
- Le cadre de transfert UE–États-Unis est en appel. Le 3 septembre 2025, le Tribunal de l'Union européenne a rejeté le recours du député Philippe Latombe contre le Data Privacy Framework. Il a formé un pourvoi le 31 octobre 2025 devant la Cour de justice (affaire C-703/25 P). Ce cadre encadre certains transferts vers des entreprises américaines certifiées ; il ne règle pas à lui seul la question des accès étatiques.
- L'État français a annoncé une migration. Les données de santé de la plateforme Health Data Hub, hébergées sur Microsoft Azure, doivent migrer vers un hébergeur qualifié SecNumCloud. L'objectif annoncé est une première copie complète de la base principale fin 2026. C'est un calendrier, pas une migration accomplie, et il montre que la réversibilité pensée après coup prend des années.
- SecNumCloud vise aussi les lois extraterritoriales. Selon l'ANSSI, cette qualification aide à identifier des offres cloud destinées à protéger les données sensibles « face à la menace cybercriminelle et à l'application de lois extraterritoriales ». Elle porte sur une offre précise et « ne préjuge pas du niveau de sécurité » des services des clients hébergés. Des offres bâties sur une technologie américaine peuvent l'obtenir, comme S3NS (Thales et Google) en décembre 2025, ce qui fait débat. C'est un repère pour les données sensibles, pas une obligation pour toute PME.
Le sujet n'est pas d'accuser un pays. C'est de savoir, pour chaque type de données, quel risque vous acceptez.
Une grille simple : partir des données, pas du modèle
La bonne question n'est pas « quel modèle est souverain ? » mais « qu'est-ce que l'agent va voir ? ». Cette grille est un premier tri, pas une règle juridique : le RGPD n'interdit pas par principe un service étranger, il impose d'analyser les rôles, les finalités, la sécurité, les sous-traitants et les transferts. Et un modèle local peut, lui aussi, traiter des données de façon non conforme.
| Ce que l'agent manipule | Exemples | Options à privilégier | À ne retenir qu'après analyse |
|---|---|---|---|
| Données publiques | Veille, contenus déjà publiés, documentation produit | Toutes les familles, y compris les services en ligne | — |
| Données internes courantes | Comptes rendus, procédures, brouillons commerciaux | Service en ligne sous contrat entreprise, sans réutilisation pour l'entraînement ; ou modèle ouvert hébergé | Comptes personnels gratuits, applications grand public |
| Données personnelles | CRM, RH, dossiers clients, e-mails | Modèle ouvert hébergé chez vous ou chez un hébergeur européen ; journaux et mémoire sous votre contrôle | Service dont vous ne savez pas où vont les requêtes et les journaux, ni qui y accède |
| Données stratégiques ou réglementées | Santé, défense, secrets industriels, marchés publics sensibles | Modèle ouvert sur votre infrastructure, ou hébergeur qualifié SecNumCloud ; exigences propres au secteur | Opérateur exposé à une loi extraterritoriale, sauf si l'analyse du contrat, du contrôle des données et des mesures techniques conclut à un risque acceptable |
- Les journaux et la mémoire de l'agent sont des données à part entière, souvent plus sensibles que les requêtes : définissez qui y accède, combien de temps ils sont gardés, comment ils sont chiffrés et supprimés.
- Les règles de l'agent ne doivent pas vivre dans le modèle (ce qu'il peut faire, ce qui demande une validation) : c'est une condition, parmi d'autres, pour pouvoir en changer.
Notre choix chez Invaist
Ce qui précède vaut pour toute PME. Ce qui suit est notre choix d'entreprise. Chez Invaist, nous privilégions les modèles open source, déployés sur l'infrastructure de nos clients. C'est, à nos yeux, ce qui laisse le plus de maîtrise à une PME sur les étages 3 à 6 : où tourne l'agent, qui l'opère, où vont les données, et la liberté de changer.
Surtout, nous construisons nos agents pour que le modèle soit remplaçable. Les droits de l'agent, la liste des actions qui exigent une validation humaine, les journaux et l'arrêt d'urgence vivent dans l'architecture, pas dans le modèle. C'est le prolongement direct de notre article Ce n'est pas l'IA qui rend un agent sûr, c'est son architecture : ce qui rend un agent sûr contribue aussi à le rendre maîtrisable.
Notre objectif d'architecture : que les données et les règles de l'agent restent sous le contrôle de l'entreprise, et qu'elle puisse changer de moteur sans tout reconstruire. Cet objectif se vérifie projet par projet, y compris pour les connecteurs, les outils de supervision et les éventuels appels sortants.
Chez Invaist, c'est notre principe de départ : l'agent exécute, l'humain décide.
Sources
- Sénat – audition de Microsoft France, 10 juin 2025
- LexisNexis – CLOUD Act et RGPD
- Le Club des juristes – le Tribunal de l'UE valide le Data Privacy Framework
- Digital Policy Alert – pourvoi C-703/25 P
- Next – Health Data Hub et SecNumCloud, février 2026
- ANSSI – cloud et SecNumCloud
- Next – S3NS qualifié SecNumCloud, décembre 2025
- Garante privacy – communiqué DeepSeek du 30 janvier 2025
- Next – définition 1.0 de l'IA open source par l'OSI
- Mistral AI – licences des modèles ouverts
- Presse-citron – lancement d'OpenEuroLLM
- YourStory – publication de gpt-oss
- Hugging Face – fiche DeepSeek-R1
- Hugging Face – fiche Qwen3-32B